先算一笔账:拖慢回复的,从来不是手速
客服回复慢怎么办?大多数团队的第一反应是:练打字、加人、上排班。方向没错,但忽略了一个更隐蔽的耗时环节。
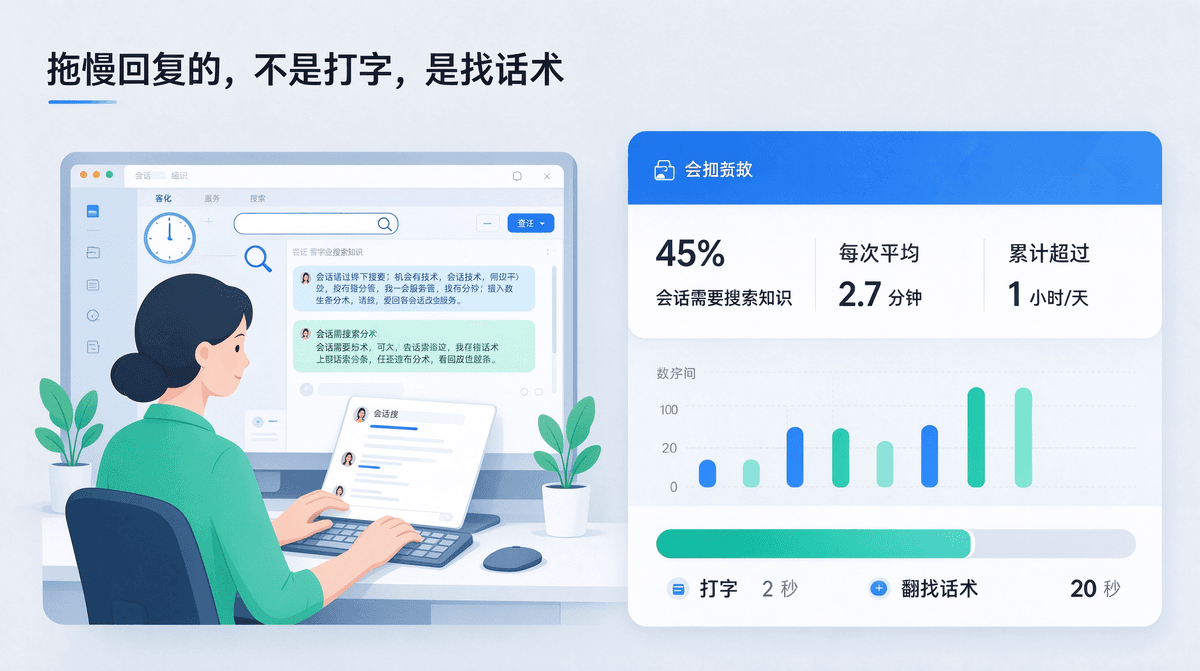
Verint 2026年对1000名联络中心客服的调研给出了一个反直觉的数据:客服在45%的会话中需要搜索知识,每次平均耗时2.7分钟。也就是说,一个客服一天接50通会话,有22通左右要停下来“找东西”,累计超过一个小时花在搜索上,而不是打字上。与此同时,行业对首响的要求却在收紧——首响≤30秒是优秀线,3分钟人工回复率≥95%是平台安全线。一边是平台掐着秒表考核,一边是客服在话术库里翻找,这两件事本身就是冲突的。
所以,“客服打字慢怎么办”这个问题的答案,很大程度上不在于打字本身。真正拖慢回复的,是“找到那句话”的时间。 快捷回复工具这个品类解决的是手速,但手速提上去之后,找话术的瓶颈反而被放大了——打一行字只要两秒,在几百上千条话术里翻到对的那一条,可能要二十秒。
关键词匹配的机制缺陷,不该让一线客服来补
市面上的客服快捷回复软件和话术管理工具,检索机制大多建立在关键词匹配或模糊匹配之上。这个机制有一个天然的天花板:它要求客服先把自己的大脑“翻译”成系统认识的关键词。
客户说“东西不想要了”,客服搜“退货”可能命不中,因为那条话术的标题叫“退款申请说明”。客户说“能便宜点吗”,客服搜“优惠”出来的可能是价格政策页,而不是真正需要的那条促单话术。更麻烦的是,不同客户的表达方式千差万别——“偏大偏小”“透不透”“起球吗”,和话术库里的“尺码建议”“面料说明”“洗涤注意”之间,隔着一层语义的墙。
竞品的解法是什么?教用户优化搜索习惯。比如建议客服“不要一开始就输入完整句子”“优先使用业务关键词,而不是口语化表达”,把“还没发”手动翻译成“发货”,把“快递没动”翻译成“物流”。再进阶一点的教程会教多关键词 AND/OR 逻辑、排除词、标签过滤、分类限定。这些方法在某些场景下确实有用,但本质上是把机制层的缺陷转嫁到了一线客服的操作习惯上。高峰期一边回消息一边做布尔逻辑运算,这件事本身就不现实。 让客服学搜索语法,不如让系统理解人话。
语义搜索和问法变体:把“猜词”这一步消灭
客服话术库的核心使用场景只有一个:客户正在等,客服需要在几秒内找到那句话发出去。这个场景需要的不是“更精确的关键词”,而是客户怎么说,系统就能怎么找。
语义搜索走的是另一条路:把客户的原话和话术内容都转化为语义向量,在向量空间里计算相似度。客户说“付不了款”,系统能召回“支付失败”“支付渠道异常”“余额不足”相关的话术;客户说“有点贵”,系统命中的是“应对嫌贵”的促单卡片,而不是价格政策说明。“付不了款”和“支付失败”之间不需要人工铺设同义词,语义层面它们本来就是近的。 技术博客里已经有成熟的工程实践在讨论这条路线,核心逻辑就是把用户query和话术都向量化,用近似最近邻检索替代穷举关键词匹配。
码动力客服助手在这条路线上的落地方式是:客户的消息原样选中,语义搜索直接召回最相关的话术候选。 配合划词捕获,一线客服不需要复制、切窗、粘贴搜索、再切回来——选中客户消息,悬浮球弹出,点一下直接发送到聊天窗口。整个“找话术”的动作被压缩成了“选中 → 点击”两步,路径上不经过搜索框,也就不需要猜词。
进一步降低检索门槛的是AI生成问法变体。一条“退货政策说明”的话术,入库时可以自动附带“不想要了”“能退吗”“不合适想换”“买了没用上”等多种口语化变体,覆盖客户真实说话方式的分布。客服不需要记住话术的标题是什么,客户怎么说,搜索就怎么命中。话术库管理工具的终点不是分类得多么整齐,而是任何一条话术在客户原话面前都能被捞出来。
不同平台的“问法发散”,语义搜索的价值不一样
“客户问法发散”不是抽象概念,每个平台都有自己的口语化分布。
抖音飞鸽客服快捷回复的场景很典型。飞鸽自带快捷短语,也支持团队和个人分类,官方建议的用法是“配合相应的编码使用”。但直播间的客户不会按编码说话。客户说“刚拍的什么时候发”“主播说的赠品有吗”,这些句子和客服后台设置的“发货时间说明”“赠品政策”之间,在关键词层面几乎没有重叠。飞鸽快捷短语的检索能力是为“客服知道该找哪一条”设计的,而直播场景恰恰是“客服不确定客户到底在问什么”的高发区。
小红书私信客服快捷回复的处境类似,但更极端。用户调研里,私信不留资的TOP3原因第一条就是“沟通不及时回复慢”。小红书私信的典型问法是“链接在哪”“还有吗”“什么价”——短句、省略主语、带着平台特有的口语节奏。一个客服如果按“商品链接”“库存状态”“价格说明”去建话术标题,客户的原话和标题之间就存在天然的检索断层。语义搜索在这种短句、高省略的场景下,容错空间比长句更大:哪怕客户只打了三个字,只要意图落在某条话术的语义半径内,就能被召回。
拼多多和快手小店的逻辑又不一样。拼多多的考核核心是3分钟人工回复率,快手小店的“快语客服工作台”同样把3分钟响应率作为核心指标。这两个平台的一线客服面临的是同一类压力:消息密度高、单条回复的容错窗口极窄。在这种节奏下,“翻分类”或“换关键词重试”的代价被放大,因为每一次搜索失败都在消耗3分钟窗口里的有效时间。
团队共享不是把话术放到一起,而是让搜索对所有人生效
“话术太多找不到”这个问题,在团队共享之后往往会变得更严重,而不是更轻。一个客服自己维护50条话术,靠记忆还能应付;十个人共享500条话术,每个人对标题的叫法都不一样,A客服搜“退货”能命中的那条,B客服搜“不想要了”就命中了。
码动力的团队共享配合的是语义搜索,而不是简单的文件夹合并。公共、小组、私有三级权限让团队话术库保持秩序,子账号不限制数量意味着新人不需要从零建立自己的快捷回复。更关键的是,新人不需要学会“老客服的搜索习惯”才能找到话术——客户原话直接搜,系统按语义召回,检索门槛对所有人是平的。一个入职第一天的客服和一个做了三年的客服,在“找到那句话”这件事上的差距,不应该由记忆力和关键词熟练度来决定。
你现在就能做的一个动作
不需要换工具,也不需要重建整个话术库。挑你话术库里使用频率最高的10条,把每条配上至少3个“客户实际会说的原话”作为检索入口。 比如“发货时间说明”下面挂上“什么时候发”“还没发货”“几天能到”;“退货政策”下面挂上“不想要了”“能退吗”“不合适”。
然后做一件事:下次高峰期,让一线客服直接把客户的消息选中去搜,而不是先在心里翻译成关键词再搜。如果搜不到,不要怪客服“不会搜”,把那条客户原话记下来,补进对应话术的检索入口里。一周之后你回头看,补进去的那些原话,就是关键词匹配一直在漏掉的东西。
客服回复慢怎么办、客服打字慢怎么办,解法不在指尖上,在检索机制里。把“猜词”这一步从一线客服的工作流里拿掉,首响和3分钟回复率的变化会自己出现在数据里。